


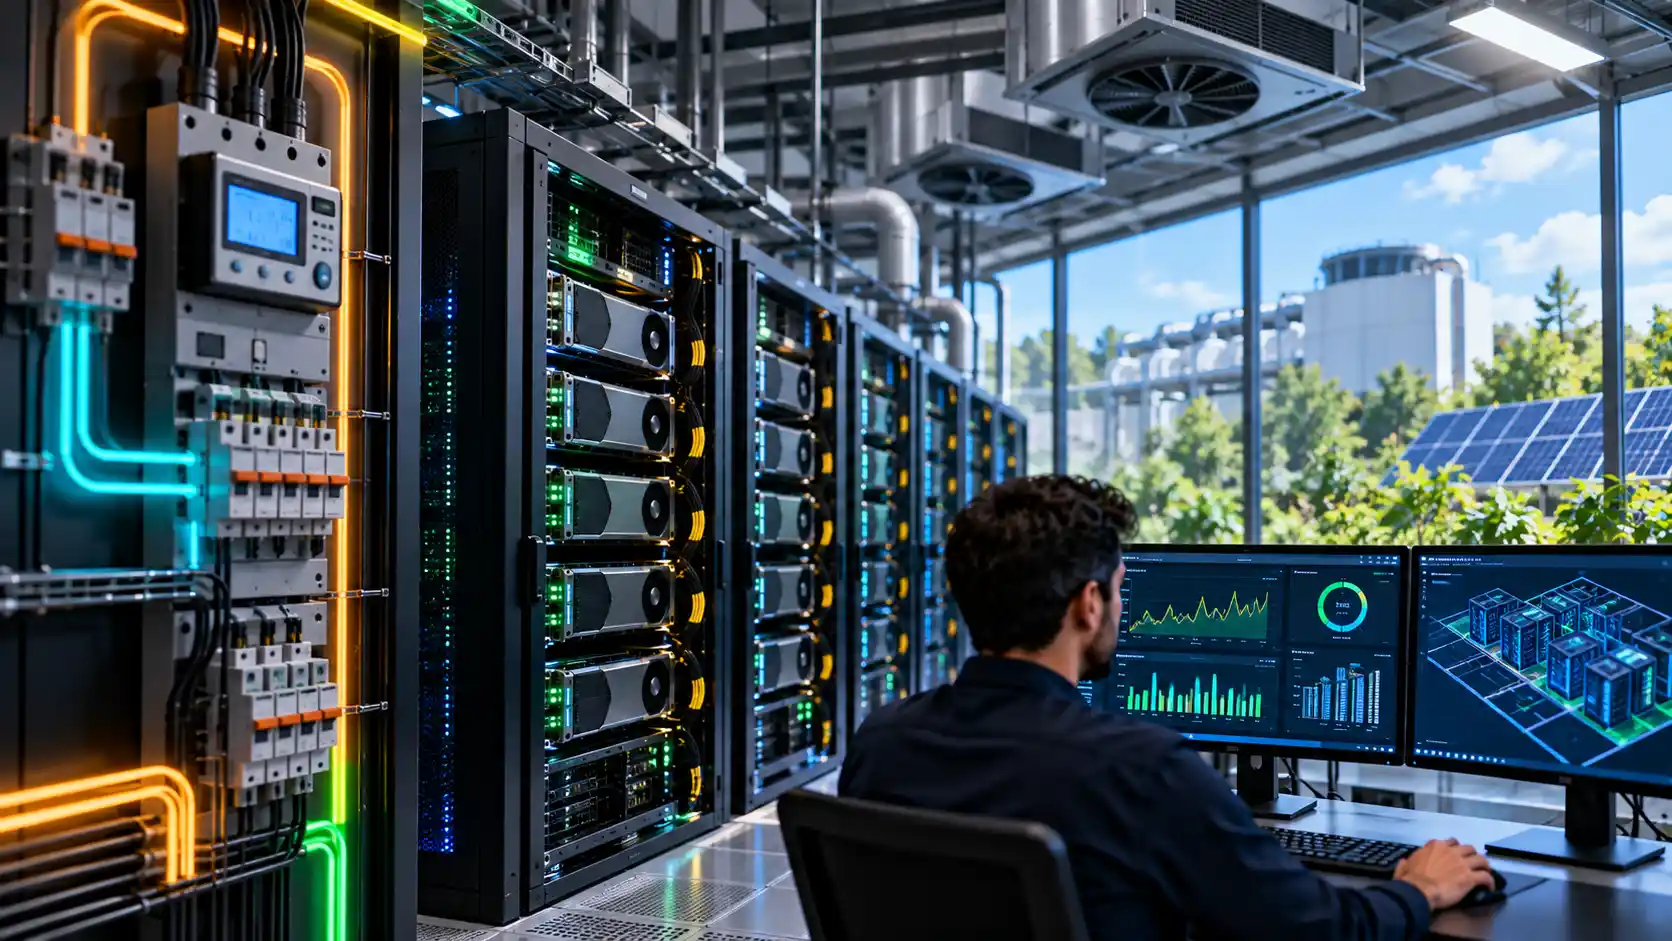
چگونه مصرف برق سرور هوش مصنوعی را کاهش دهیم؟ با روشهای بهینهسازی GPU، مدیریت انرژی، خنکسازی و کاهش هزینه برق آشنا شوید.
سرورهای هوش مصنوعی به دلیل استفاده از پردازندههای قدرتمند، کارتهای گرافیک تخصصی، حافظههای پرسرعت و تجهیزات شبکه پیشرفته، معمولاً انرژی بیشتری نسبت به بسیاری از سرورهای سازمانی معمولی مصرف میکنند. با افزایش استفاده از هوش مصنوعی در کسبوکارها، مدیریت مصرف برق این تجهیزات به یکی از مهمترین دغدغههای مدیران شبکه، متخصصان IT و مدیران دیتاسنتر تبدیل شده است.
مصرف بالای برق نهتنها هزینههای عملیاتی سازمان را افزایش میدهد، بلکه به سیستم خنککننده قویتر، زیرساخت برق مناسبتر و برنامهریزی دقیقتری برای نگهداری تجهیزات نیاز دارد. به همین دلیل، مدیریت مصرف انرژی باید از مرحله طراحی و انتخاب سختافزار آغاز شود و در زمان استفاده از سرور نیز ادامه پیدا کند.
برای مثال، یک سرور هوش مصنوعی که برای آموزش مدلهای یادگیری عمیق استفاده میشود، ممکن است ساعتها با بار پردازشی سنگین فعالیت کند. در چنین شرایطی، حتی کاهش اندک مصرف انرژی به ازای هر واحد پردازش میتواند در بلندمدت صرفهجویی قابلتوجهی ایجاد کند.
در این مقاله بررسی میکنیم که چرا سرورهای هوش مصنوعی برق زیادی مصرف میکنند، کدام قطعات بیشترین تأثیر را بر مصرف انرژی دارند و چگونه میتوان با انتخاب سختافزار مناسب، تنظیم توان GPU، بهینهسازی خنکسازی و مانیتورینگ دقیق، هزینه برق را کنترل کرد. همچنین نکات مهمی را که هنگام خرید سرور هوش مصنوعی باید در نظر بگیرید، توضیح میدهیم.
سرور هوش مصنوعی برای اجرای الگوریتمهای یادگیری ماشین، آموزش شبکههای عصبی، پردازش تصویر، تحلیل دادههای حجیم و اجرای مدلهای زبانی بزرگ طراحی میشود. این پردازشها به توان محاسباتی زیادی نیاز دارند و به همین دلیل، در بسیاری از زیرساختهای AI از چندین پردازنده گرافیکی یا GPU بهصورت همزمان استفاده میشود.
GPUها به دلیل معماری پردازش موازی، قادرند تعداد زیادی عملیات محاسباتی را بهصورت همزمان انجام دهند. این ویژگی باعث افزایش سرعت اجرای مدلهای هوش مصنوعی میشود؛ اما در زمان فعالیت سنگین، مصرف برق و تولید گرما نیز افزایش پیدا میکند.
البته GPU تنها عامل مصرف انرژی نیست. پردازنده مرکزی یا CPU، رم سرور، حافظههای SSD و NVMe، کارتهای شبکه پرسرعت، مادربرد، فنها و منبع تغذیه نیز در مصرف نهایی نقش دارند.
از طرف دیگر، گرمای تولیدشده توسط تجهیزات باید از محیط خارج شود. بنابراین علاوه بر برق مصرفی خود سرور، انرژی مورد نیاز برای سرمایش دیتاسنتر نیز باید محاسبه شود.
مهمترین عوامل مؤثر بر مصرف برق سرورهای هوش مصنوعی عبارتاند از:
بنابراین، برای کاهش مصرف برق نباید تنها روی یک قطعه تمرکز کرد. بهترین نتیجه زمانی حاصل میشود که کل زیرساخت، از سختافزار و نرمافزار گرفته تا سیستم برق و سرمایش، بهصورت یکپارچه بهینه شود.
سرورهای معمولی معمولاً برای اجرای نرمافزارهای سازمانی، میزبانی وبسایت، پایگاه داده، سرویسهای شبکه و مجازیسازی عمومی استفاده میشوند. در این سرورها، مصرف انرژی به نوع پردازنده، تعداد دیسکها، میزان استفاده از حافظه و بار کاری بستگی دارد.
در مقابل، سرورهای هوش مصنوعی ممکن است چند GPU پرقدرت داشته باشند که هنگام آموزش مدل یا اجرای پردازشهای سنگین، سهم بزرگی از مصرف برق کل سیستم را به خود اختصاص میدهند.
تفاوت اصلی این دو نوع سرور در نوع بار کاری و تراکم محاسباتی است. یک سرور AI ممکن است برای مدت طولانی با استفاده بالا از GPU فعالیت کند، در حالی که بعضی سرورهای سازمانی بار پردازشی متغیرتری دارند.
برای مثال، اگر سازمانی تنها به اجرای یک مدل سبک برای دستهبندی تصاویر نیاز داشته باشد، ممکن است یک سرور مجهز به GPU میانرده پاسخگوی نیاز آن باشد. اما برای آموزش یک مدل بزرگ یا اجرای همزمان چند مدل زبانی، به سختافزار قدرتمندتر و در نتیجه زیرساخت برق و سرمایش مناسبتری نیاز خواهد بود.
نکته مهم این است که مصرف برق بالاتر همیشه به معنای بهرهوری پایینتر نیست. گاهی یک سرور قدرتمندتر، پردازش را سریعتر تمام میکند و در مجموع انرژی کمتری برای انجام همان کار مصرف میشود. به همین دلیل، عملکرد به ازای وات یکی از معیارهای مهم ارزیابی زیرساختهای هوش مصنوعی است.
اولین قدم برای مدیریت انرژی، اندازهگیری مصرف واقعی است. تا زمانی که مشخص نباشد کدام بخش از زیرساخت بیشترین برق را مصرف میکند، انتخاب راهکار مناسب دشوار خواهد بود.
مشخصات درجشده روی پاور یا کارت گرافیک میتوانند برای برآورد اولیه مفید باشند، اما لزوماً نشاندهنده مصرف واقعی سیستم در شرایط کاری مختلف نیستند.
برای اندازهگیری بهتر، مصرف سرور را در چند وضعیت بررسی کنید:
حالت بیکار یا Idle: سرور روشن است، اما پردازش سنگینی انجام نمیدهد.
حالت بار متوسط: سرور در حال اجرای سرویسهای عادی یا workloadهای متوسط است.
حالت بار سنگین: GPU و CPU برای اجرای مدلهای هوش مصنوعی بهشدت درگیر هستند.
حالت اوج مصرف: چند منبع پردازشی بهصورت همزمان فعال شدهاند و مصرف به مقادیر بالاتر نزدیک میشود.
برای این کار میتوان از قابلیتهای مدیریتی سرور، تجهیزات اندازهگیری برق، PDUهای هوشمند و ابزارهای مانیتورینگ استفاده کرد. در سمت GPU نیز ابزارهایی مانند NVIDIA-smi و NVIDIA DCGM میتوانند اطلاعاتی درباره توان مصرفی، دما و میزان استفاده از منابع ارائه دهند.
ثبت این اطلاعات در طول زمان کمک میکند الگوی مصرف مشخص شود و بتوان تغییرات ناشی از تنظیمات یا ارتقای سختافزار را ارزیابی کرد.

یکی از روشهای کاربردی برای مدیریت مصرف انرژی، تعیین سقف توان مصرفی GPU یا Power Limit است.
در این روش، برای پردازنده گرافیکی یک محدوده توان مشخص تعیین میشود تا مصرف آن از مقدار تنظیمشده فراتر نرود. این قابلیت در GPUها و درایورهای پشتیبانیشده وجود دارد و میتواند برای کنترل مصرف سرورهای متراکم و دیتاسنترها مفید باشد.
برای مثال، ممکن است یک GPU در حالت پیشفرض هنگام اجرای پردازش سنگین به توان بالاتری نیاز داشته باشد. با کاهش منطقی سقف توان، میتوان مصرف انرژی را کنترل کرد؛ هرچند میزان تأثیر آن بر عملکرد به مدل GPU و نوع پردازش بستگی دارد.
اجرای این روش باید با آزمایش واقعی همراه باشد. اگر Power Limit بیش از حد کاهش پیدا کند، GPU ممکن است فرکانس کاری خود را پایین بیاورد و زمان اجرای مدل افزایش یابد.
روش مناسب این است که چند مقدار توان آزمایش شود و برای هرکدام موارد زیر اندازهگیری شوند:
در نهایت باید تنظیمی انتخاب شود که ضمن حفظ عملکرد مورد نیاز، مصرف انرژی را کاهش دهد.
یکی از اشتباهات رایج در طراحی زیرساخت هوش مصنوعی، انتخاب قدرتمندترین GPU بدون بررسی نیاز واقعی پروژه است.
همه پروژههای AI به سختافزار یکسانی نیاز ندارند. برای اجرای مدلهای سبک، پردازش تصویر یا inference محدود، ممکن است GPUهای میانرده عملکرد مناسبی ارائه دهند. در مقابل، آموزش مدلهای بزرگ و اجرای مدلهای زبانی با پارامترهای فراوان ممکن است به GPUهایی با حافظه بیشتر و توان محاسباتی بالاتر نیاز داشته باشد.
هنگام انتخاب GPU باید موارد زیر بررسی شوند:
گاهی انتخاب یک GPU قدرتمندتر باعث میشود پردازش سریعتر انجام شود و زمان فعالیت سیستم کاهش پیدا کند. در شرایط دیگر، یک GPU کممصرفتر برای بار کاری سبک گزینه اقتصادیتری است.
بنابراین انتخاب سختافزار باید بر اساس معیارهای عملکرد، انرژی و هزینه انجام شود، نه فقط نام مدل یا تعداد هستههای پردازشی.
برای مدیریت اصولی مصرف برق، بهتر است به جای تمرکز صرف بر توان مصرفی، میزان کار مفیدی را که سرور در ازای انرژی مصرفشده انجام میدهد بررسی کنید.
این معیار با عنوان Performance per Watt شناخته میشود.
برای مثال، فرض کنید دو سرور یک وظیفه مشخص را اجرا میکنند. سرور اول برق کمتری مصرف میکند، اما برای تکمیل کار به زمان بسیار بیشتری نیاز دارد. سرور دوم برق بیشتری مصرف میکند، اما پردازش را سریعتر به پایان میرساند.
در این وضعیت، نمیتوان تنها بر اساس مصرف لحظهای تصمیم گرفت کدام سرور بهینهتر است. باید انرژی مصرفشده برای تکمیل کل کار مقایسه شود.
در پروژههای مختلف میتوان معیارهای اختصاصی نیز تعریف کرد؛ مانند انرژی مصرفی برای هر inference، تعداد تصاویر پردازششده به ازای هر کیلوواتساعت یا تعداد توکن تولیدشده به ازای هر واحد انرژی در مدلهای زبانی.
این روش به سازمان کمک میکند GPU و تنظیماتی را انتخاب کند که علاوه بر توان مناسب، هزینه عملیاتی کمتری ایجاد میکنند.
خنکسازی یکی از عوامل مهم در هزینه انرژی زیرساختهای هوش مصنوعی است. GPUهای قدرتمند در زمان پردازش سنگین گرمای زیادی تولید میکنند و این گرما باید بهصورت پیوسته از محیط خارج شود.
اگر جریان هوا در شاسی سرور یا رک بهدرستی طراحی نشده باشد، هوای گرم ممکن است دوباره وارد تجهیزات شود. این اتفاق میتواند دما را افزایش دهد و باعث شود فنها با سرعت بالاتری کار کنند.
برای بهینهسازی خنکسازی، اقدامات زیر مفید هستند:
در سرورهای بسیار متراکم، بهخصوص سیستمهایی که چندین GPU قدرتمند دارند، ممکن است خنکسازی مایع نیز گزینه مناسبی باشد. با این حال، انتخاب آن باید بر اساس توان حرارتی، هزینه اجرا، نگهداری و طراحی دیتاسنتر انجام شود.
کاهش مصرف برق سیستم سرمایش نیز باید در کنار حفظ دمای ایمن تجهیزات بررسی شود. افزایش بیش از حد دمای محیط برای کاهش هزینه سرمایش میتواند نتیجه معکوس داشته باشد.
منبع تغذیه یا Power Supply وظیفه تأمین برق قطعات مختلف سرور را بر عهده دارد. انتخاب پاور مناسب برای سرورهای هوش مصنوعی اهمیت زیادی دارد؛ زیرا تعداد GPUها و توان مصرفی آنها میتواند نیاز برق سیستم را بهشدت افزایش دهد.
برای انتخاب پاور باید مصرف احتمالی GPUها، CPU، حافظه، تجهیزات ذخیرهسازی، کارتهای شبکه، فنها و سایر اجزا محاسبه شود.
سپس باید شرایط اوج مصرف، نیاز به افزونگی و امکان توسعه آینده نیز در نظر گرفته شود.
پاور با ظرفیت بسیار بالا الزاماً انتخاب بهینهای نیست؛ همانطور که استفاده از پاور ضعیف نیز میتواند به ناپایداری سیستم منجر شود. علاوه بر ظرفیت، راندمان تبدیل برق در سطح بار کاری واقعی نیز اهمیت دارد.
در سرورهای سازمانی، قابلیتهایی مانند پاور افزونه یا Redundant Power Supply نیز باید بررسی شوند. این قابلیتها برای افزایش پایداری مفید هستند، اما طراحی و نحوه توزیع بار میان پاورها باید متناسب با نیاز زیرساخت باشد.
هنگام طراحی سرور AI، مشخصات پیشنهادی سازنده شاسی و GPU باید مبنای محاسبه قرار گیرد؛ زیرا ظرفیت پاور، اتصالات برق و محدودیتهای حرارتی بین مدلهای مختلف متفاوت است.
با وجود اهمیت GPU، نباید مصرف انرژی پردازنده مرکزی و حافظه سرور را نادیده گرفت.
CPU وظایفی مانند آمادهسازی دادهها، مدیریت پردازش، اجرای سیستمعامل و هماهنگی بین بخشهای مختلف برنامه را بر عهده دارد. اگر CPU به اندازه کافی قدرتمند نباشد، ممکن است GPU منتظر دریافت داده بماند. از طرف دیگر، انتخاب پردازندهای بسیار قدرتمندتر از نیاز پروژه نیز میتواند هزینه و مصرف انرژی را افزایش دهد.
رم سرور نیز در اجرای مدلهای هوش مصنوعی نقش مهمی دارد. ظرفیت ناکافی حافظه میتواند باعث استفاده بیشتر از حافظه ذخیرهسازی و کاهش عملکرد شود. در مقابل، ظرفیت مناسب رم به اجرای روانتر پردازشها کمک میکند.
برای بهینهسازی این بخشها باید موارد زیر بررسی شوند:
هدف این نیست که همه قطعات را به کممصرفترین مدل ممکن محدود کنیم؛ بلکه باید منابع متناسب با نیاز انتخاب شوند تا هیچ قطعهای بدون ایجاد ارزش عملیاتی، انرژی زیادی مصرف نکند.
یکی از راههای ساده اما مؤثر برای کاهش مصرف برق، شناسایی سرورها و منابعی است که در بخش زیادی از زمان فعالیت، استفاده مفیدی ندارند.
ممکن است یک سرور برای اجرای چند پردازش محدود در طول روز روشن باقی بماند یا چند ماشین مجازی منابع سختافزاری را بهصورت غیرضروری اشغال کنند.
در چنین شرایطی میتوان با بررسی الگوی مصرف و برنامه زمانبندی پردازشها، استفاده از منابع را بهینه کرد.
راهکارهای پیشنهادی عبارتاند از:
البته خاموش کردن سرورها باید با توجه به سطح سرویس، دسترسپذیری و زمان مورد نیاز برای راهاندازی مجدد انجام شود. در سیستمهایی که باید شبانهروزی پاسخگو باشند، ممکن است مدیریت ظرفیت و تجمیع workloadها گزینه مناسبتری باشد.
در بعضی سازمانها، چند پروژه هوش مصنوعی بهصورت همزمان اجرا میشوند؛ اما هر پروژه به تمام ظرفیت یک GPU نیاز ندارد.
در این شرایط، استفاده از قابلیتهای مجازیسازی یا اشتراکگذاری منابع GPU، در صورت پشتیبانی سختافزار و نرمافزار، میتواند بهرهوری منابع را افزایش دهد.
برای مثال، به جای اختصاص کامل یک GPU به چند پردازش سبک و کممصرف، میتوان منابع را با توجه به نیاز هر workload مدیریت کرد.
مزایای احتمالی این روش عبارتاند از:
البته مجازیسازی همیشه به معنای کاهش مصرف لحظهای برق نیست. مزیت اصلی آن میتواند افزایش بهرهوری و کاهش انرژی مصرفی به ازای هر کار باشد.
همچنین باید سازگاری GPU، درایور، نرمافزار مجازیسازی و نیازهای عملکردی پروژه بررسی شود.
مانیتورینگ به مدیران IT کمک میکند وضعیت مصرف انرژی را در طول زمان مشاهده کنند و پیش از تبدیل شدن یک مشکل به اختلال جدی، اقدامات لازم را انجام دهند.
در زیرساختهای مجهز به GPUهای NVIDIA، ابزارهایی مانند nvidia-smi و NVIDIA DCGM میتوانند اطلاعات مربوط به توان مصرفی، دما، کلاک و میزان استفاده از منابع را در مدلهای پشتیبانیشده ارائه کنند.
در سطح سرور نیز ابزارهای مدیریتی سازنده، حسگرهای سختافزاری و سیستمهای مانیتورینگ میتوانند اطلاعاتی درباره مصرف برق، دما و وضعیت فنها فراهم کنند.
برای داشتن یک سیستم مانیتورینگ مؤثر، بهتر است شاخصهای زیر ثبت شوند:
با کنار هم قرار دادن دادههای مصرف و عملکرد، میتوان مشخص کرد که کدام تنظیمات بیشترین صرفهجویی را ایجاد کردهاند.
در زیرساختهای بزرگ، بررسی مصرف هر سرور بهتنهایی کافی نیست. مجموع مصرف چند سرور GPU در یک رک ممکن است به ظرفیت طراحیشده تجهیزات برق نزدیک شود یا از آن عبور کند.
به همین دلیل باید ظرفیت PDU، UPS، مسیرهای توزیع برق و محدودیتهای هر رک بررسی شوند.
برای مثال، نصب چند سرور قدرتمند در یک رک ممکن است از نظر فضای فیزیکی امکانپذیر باشد، اما ظرفیت برق یا سرمایش موجود برای فعالیت همزمان تمام آنها کافی نباشد.
برای جلوگیری از این مشکل میتوان از اقدامات زیر استفاده کرد:
در دیتاسنترهای بزرگ، مدیریت انرژی باید از سطح قطعه تا رک و کل ساختمان بهصورت یکپارچه انجام شود.
یکی از شاخصهای شناختهشده برای ارزیابی بهرهوری انرژی دیتاسنتر، PUE یا Power Usage Effectiveness است.
فرمول محاسبه این شاخص به شکل زیر است:
PUE = کل انرژی مصرفی دیتاسنتر ÷ انرژی مصرفی تجهیزات IT
برای مثال، اگر دیتاسنتر در یک بازه زمانی ۱۲۰۰ کیلوواتساعت انرژی مصرف کند و تجهیزات IT آن ۱۰۰۰ کیلوواتساعت مصرف داشته باشند، مقدار PUE برابر با ۱٫۲ خواهد بود.
هرچه مقدار PUE به عدد ۱ نزدیکتر باشد، سهم انرژی مصرفی تجهیزات جانبی مانند سرمایش و توزیع برق کمتر است.
البته PUE بهتنهایی نشان نمیدهد که یک سرور هوش مصنوعی چقدر کار مفید انجام میدهد. برای ارزیابی کامل، باید این شاخص را در کنار معیارهایی مانند انرژی مصرفی به ازای هر پردازش، عملکرد به ازای وات و میزان استفاده از منابع بررسی کرد.
در نتیجه، بهینهسازی دیتاسنتر و بهینهسازی خود workload دو اقدام مکمل هستند و نباید یکی را جایگزین دیگری دانست.
برای برآورد هزینه برق، باید مصرف واقعی سرور و مدتزمان فعالیت آن مشخص باشد.
فرمول ساده محاسبه انرژی مصرفی چنین است:
انرژی مصرفی بر حسب کیلوواتساعت = توان متوسط بر حسب کیلووات × مدت فعالیت بر حسب ساعت
برای نمونه، فرض کنید توان متوسط یک سرور در زمان فعالیت ۱٫۵ کیلووات باشد و این سرور روزانه ۱۰ ساعت با همین توان کار کند.
مصرف انرژی روزانه آن برابر است با:
۱٫۵ × ۱۰ = ۱۵ کیلوواتساعت
اگر این الگوی مصرف در تمام ۳۰ روز ماه تکرار شود، مصرف ماهانه سرور به ۴۵۰ کیلوواتساعت میرسد.
برای محاسبه هزینه، کافی است این مقدار در تعرفه برق مربوطه ضرب شود. البته این مثال فرضی است و مصرف واقعی به مدل سختافزار، workload، زمان فعالیت و شرایط خنکسازی بستگی دارد.
همچنین اگر هدف محاسبه هزینه کل زیرساخت باشد، باید سهم مصرف سیستم سرمایش، UPS و تجهیزات جانبی را نیز در نظر گرفت.
کاهش مصرف لحظهای الزاماً به معنای کاهش هزینه کل اجرای یک پردازش نیست.
فرض کنید با محدود کردن توان GPU، مصرف برق آن کاهش پیدا کند؛ اما مدتزمان اجرای مدل افزایش یابد. در این وضعیت، ممکن است صرفهجویی واقعی کمتر از انتظار باشد.
به همین دلیل، برای ارزیابی نتیجه باید انرژی مصرفشده برای تکمیل یک کار مشخص اندازهگیری شود.
در پروژههای هوش مصنوعی میتوان معیارهایی مانند انرژی مصرفی برای آموزش یک مدل، انرژی مورد نیاز برای اجرای هر inference، تعداد درخواستهای پردازششده به ازای هر کیلوواتساعت یا تعداد توکن تولیدشده به ازای واحد انرژی را بررسی کرد.
این رویکرد کمک میکند تصمیمگیری بر اساس نتیجه واقعی انجام شود، نه صرفاً کاهش توان مصرفی قطعات.
مدیریت مصرف برق از زمان انتخاب تجهیزات شروع میشود. اگر سرور از ابتدا متناسب با نیاز پروژه طراحی شود، احتمال خرید قطعات غیرضروری و ایجاد هزینههای عملیاتی بالا کاهش پیدا میکند.
هنگام خرید سرور هوش مصنوعی، ابتدا نوع workload را مشخص کنید. آیا سرور برای آموزش مدل، اجرای inference، پردازش تصویر، تحلیل داده یا مدلهای زبانی بزرگ استفاده خواهد شد؟
سپس موارد زیر را بررسی کنید:
۱. انتخاب GPU مناسب: ظرفیت VRAM، توان محاسباتی، مصرف برق و سازگاری نرمافزاری باید متناسب با پروژه باشند.
۲. انتخاب CPU: پردازنده باید بتواند دادهها را با سرعت مناسب آماده کند و مانع استفاده ناکافی از GPU نشود.
۳. ظرفیت رم سرور: مقدار حافظه باید برای دادهها، مدلها و پردازشهای همزمان کافی باشد.
۴. تجهیزات ذخیرهسازی: انتخاب SSD یا NVMe مناسب میتواند سرعت دسترسی به دادهها را افزایش دهد و از ایجاد گلوگاه جلوگیری کند.
۵. پاور سرور: ظرفیت، راندمان، اتصالات و قابلیت افزونگی باید بررسی شوند.
۶. خنکسازی: شاسی و سیستم سرمایش باید توان دفع حرارت تولیدشده توسط قطعات را داشته باشند.
۷. قابلیت توسعه: امکان افزودن GPU، رم، ذخیرهسازی یا کارت شبکه در آینده میتواند از تعویض زودهنگام کل سرور جلوگیری کند.
۸. هزینه مالکیت: هزینه خرید تنها بخشی از هزینه نهایی است. برق، سرمایش، نگهداری و ارتقا نیز باید محاسبه شوند.
با بررسی این موارد، میتوان سروری انتخاب کرد که علاوه بر عملکرد مناسب، از نظر مصرف انرژی و هزینه عملیاتی نیز توجیهپذیر باشد.
قیمت سرور هوش مصنوعی تنها به پردازنده یا کارت گرافیک آن وابسته نیست. تعداد GPUها، ظرفیت حافظه گرافیکی، نوع CPU، مقدار رم، تجهیزات ذخیرهسازی، پاور و سیستم خنککننده همگی بر هزینه نهایی تأثیر میگذارند.
از طرف دیگر، مصرف برق نیز بخشی از هزینه مالکیت سرور است. ممکن است دو سرور قیمت خرید متفاوتی داشته باشند، اما یکی از آنها به دلیل عملکرد بهتر یا بهرهوری انرژی بالاتر، در بلندمدت گزینه اقتصادیتری باشد.
برای مقایسه قیمت سرور هوش مصنوعی باید موارد زیر را در نظر گرفت:
بنابراین بهتر است قیمت سرور را در کنار هزینه عملیاتی و کارایی آن بررسی کنید. انتخاب ارزانترین سرور بدون توجه به توان پردازشی و مصرف انرژی ممکن است در نهایت هزینه بیشتری ایجاد کند.
برخی اشتباهات در طراحی و نگهداری زیرساخت میتوانند باعث افزایش هزینه انرژی شوند.
انتخاب GPU بدون توجه به نوع پروژه: استفاده از GPU بسیار قدرتمند برای workload سبک میتواند هزینه اولیه و مصرف انرژی غیرضروری ایجاد کند.
نادیده گرفتن مصرف واقعی: مشخصات اسمی تجهیزات برای برآورد اولیه مفید هستند، اما جایگزین اندازهگیری مصرف واقعی نمیشوند.
کاهش بیش از حد Power Limit: محدود کردن شدید توان ممکن است عملکرد را کاهش دهد و زمان اجرای پردازش را افزایش دهد.
بیتوجهی به خنکسازی: جریان هوای نامناسب و گردش مجدد هوای گرم میتواند کارایی سیستم سرمایش را کاهش دهد.
انتخاب پاور نامناسب: پاور باید متناسب با بار کاری، نیاز به افزونگی و مشخصات سازنده انتخاب شود.
نادیده گرفتن مصرف کل رک: چند سرور ممکن است بهصورت جداگانه در محدوده مجاز باشند، اما مجموع مصرف آنها از ظرفیت زیرساخت فراتر برود.
عدم بررسی هزینه مالکیت: مقایسه قیمت اولیه بدون در نظر گرفتن هزینه برق، سرمایش و نگهداری تصویر کاملی از اقتصادی بودن سرور ارائه نمیدهد.
مدیریت مصرف برق سرورهای هوش مصنوعی به مجموعهای از اقدامات فنی و مدیریتی نیاز دارد. انتخاب GPU متناسب با workload، تنظیم Power Limit، مانیتورینگ مصرف انرژی، بهینهسازی سیستم خنککننده، انتخاب پاور مناسب و مدیریت منابع بلااستفاده از مهمترین راهکارهای این حوزه هستند.
همچنین لازم است هزینه برق و سرمایش در کنار قیمت اولیه تجهیزات بررسی شود. سروری که توان پردازشی بیشتری دارد، الزاماً از نظر اقتصادی بهترین انتخاب نیست؛ همانطور که انتخاب یک سیستم کممصرف با عملکرد ناکافی نیز ممکن است هزینه اجرای پروژه را افزایش دهد.
بهترین راهکار، انتخاب زیرساختی است که تعادل مناسبی میان عملکرد، مصرف انرژی، پایداری، هزینه و امکان توسعه آینده ایجاد کند.
برای طراحی یک زیرساخت هوش مصنوعی کارآمد، انتخاب صحیح GPU، پردازنده، رم سرور، تجهیزات ذخیرهسازی، پاور و قطعات شبکه اهمیت زیادی دارد. شرکت پویه پرداز افق بهعنوان عرضهکننده تجهیزات سرور و شبکه، میتواند در بررسی نیازهای سختافزاری و انتخاب تجهیزات متناسب با پروژه به شما کمک کند.
اگر قصد خرید سرور هوش مصنوعی یا ارتقای زیرساخت فعلی خود را دارید، بهتر است پیش از انتخاب تجهیزات، نوع workload، ظرفیت پردازشی مورد نیاز، محدودیت برق و نیازهای خنکسازی را مشخص کنید.
برای بررسی قیمت سرور هوش مصنوعی نیز باید مشخصات فنی، تعداد GPUها، ظرفیت حافظه، تجهیزات جانبی و قابلیت توسعه سیستم در نظر گرفته شوند. انتخاب آگاهانه میتواند از خرید تجهیزات نامتناسب جلوگیری کند و هزینههای عملیاتی را در بلندمدت کاهش دهد.
به دلیل استفاده از GPUهای قدرتمند، پردازندههای چند هستهای، حافظههای پرسرعت و تجهیزات خنککننده. میزان مصرف به مدل سختافزار و نوع workload بستگی دارد.
اندازهگیری مصرف واقعی، انتخاب سختافزار متناسب با پروژه، تنظیم Power Limit در تجهیزات پشتیبانیشده، مدیریت منابع بلااستفاده و بهینهسازی خنکسازی از مهمترین راهکارها هستند.
ممکن است. میزان افت عملکرد به مدل GPU و نوع پردازش بستگی دارد. بنابراین باید تنظیمات مختلف آزمایش شوند تا تعادل مناسبی میان مصرف برق و عملکرد ایجاد شود.
خیر. یک GPU قویتر ممکن است برق بیشتری در لحظه مصرف کند، اما پردازش را سریعتر به پایان برساند. برای مقایسه صحیح باید انرژی مصرفشده برای انجام یک کار مشخص اندازهگیری شود.
تعداد و مدل GPU، ظرفیت VRAM، نوع CPU، مقدار رم، تجهیزات ذخیرهسازی، پاور، خنکسازی و قابلیت توسعه از عوامل مهم تعیینکننده قیمت هستند.
ابتدا توان متوسط سرور و مدت فعالیت آن را اندازهگیری کنید. سپس مصرف انرژی را بر حسب کیلوواتساعت محاسبه و در تعرفه برق ضرب کنید. برای برآورد هزینه کل زیرساخت، سهم سرمایش و تجهیزات جانبی را نیز در نظر بگیرید.
ممکن است در زیرساختهای پرتراکم، خنکسازی مایع به دفع مؤثرتر گرما کمک کند؛ اما نتیجه نهایی به طراحی سیستم، تجهیزات پمپاژ، مبدلهای حرارتی و شرایط دیتاسنتر وابسته است. باید کل سیستم مقایسه شود.

دیدگاهتان را بنویسید